

训练一个超级棒的风格
如果你是 Krea 用户,你已经是文本提示词高手了。你可能也训练过 LoRA。但怎样才能做出一个出色的自定义模型呢? Krea 训练的 3 个关键步骤:- 策展
- 你需要顶级图像——高质量、高一致性。你是策展人,Krea 就是你的画廊。
- 精调
- Krea 让调整所有技术参数变得超级简单——基础模型、训练步数等等。尽情微调吧。
- 炼金
- 先说清楚:风格训练本身就是一门艺术,而不是精确的科学。如果训练结果没达到预期,别慌。这是一个反复试错、创造神奇作品的过程。迭代、迭代、再迭代!
提示词:An alchemist in their laboratory distilling an elixir, abstract. 使用 Krea 1 模型和自定义风格制作。
1. 策展
上传
在 Krea.ai 上点击 Home 图标,在资源下点击 Train。或者直接向下滚动。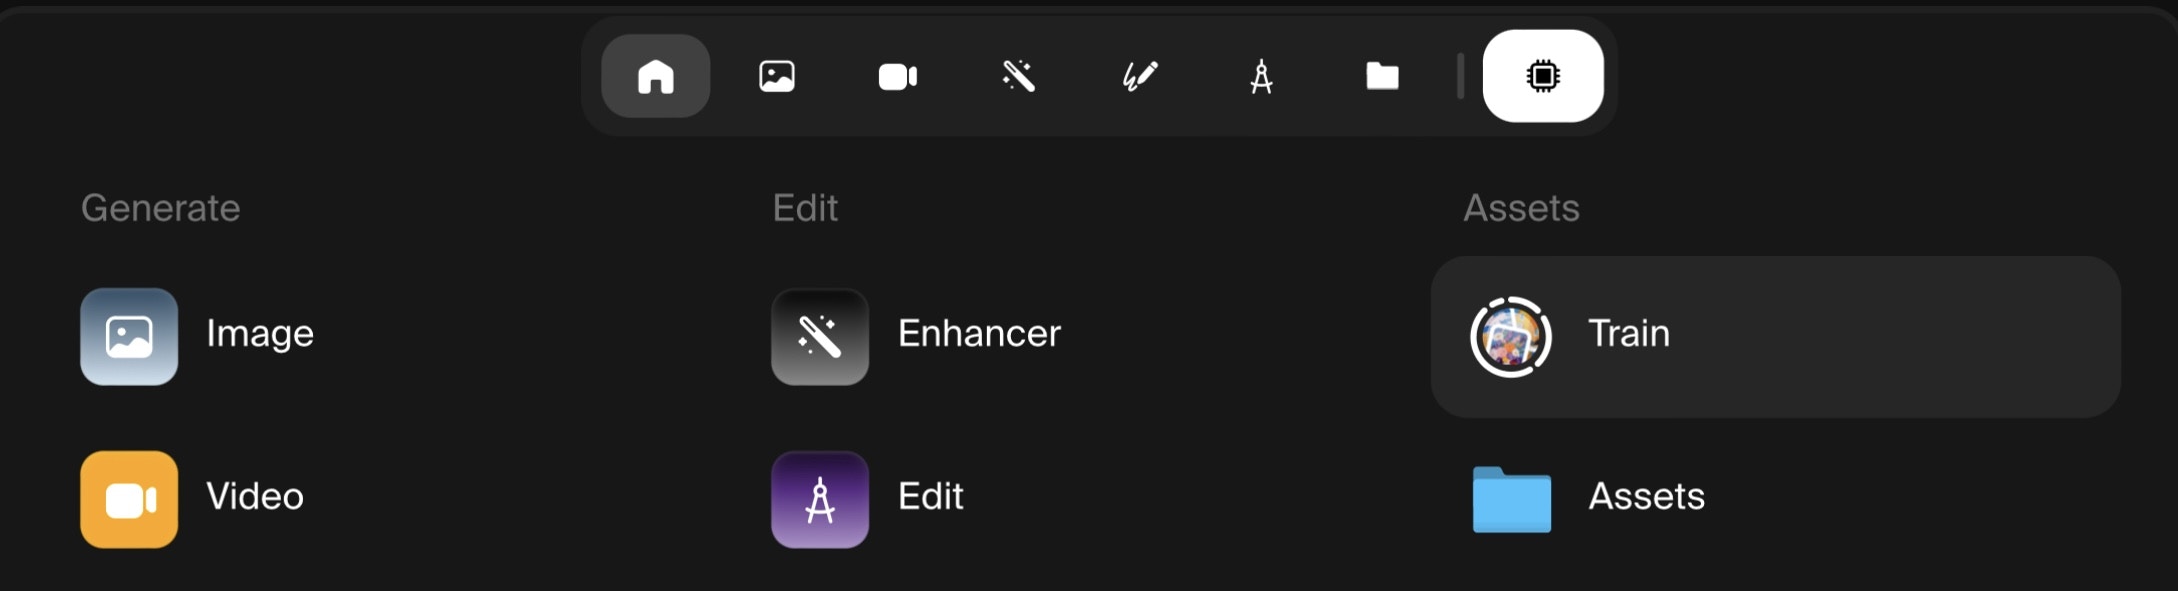
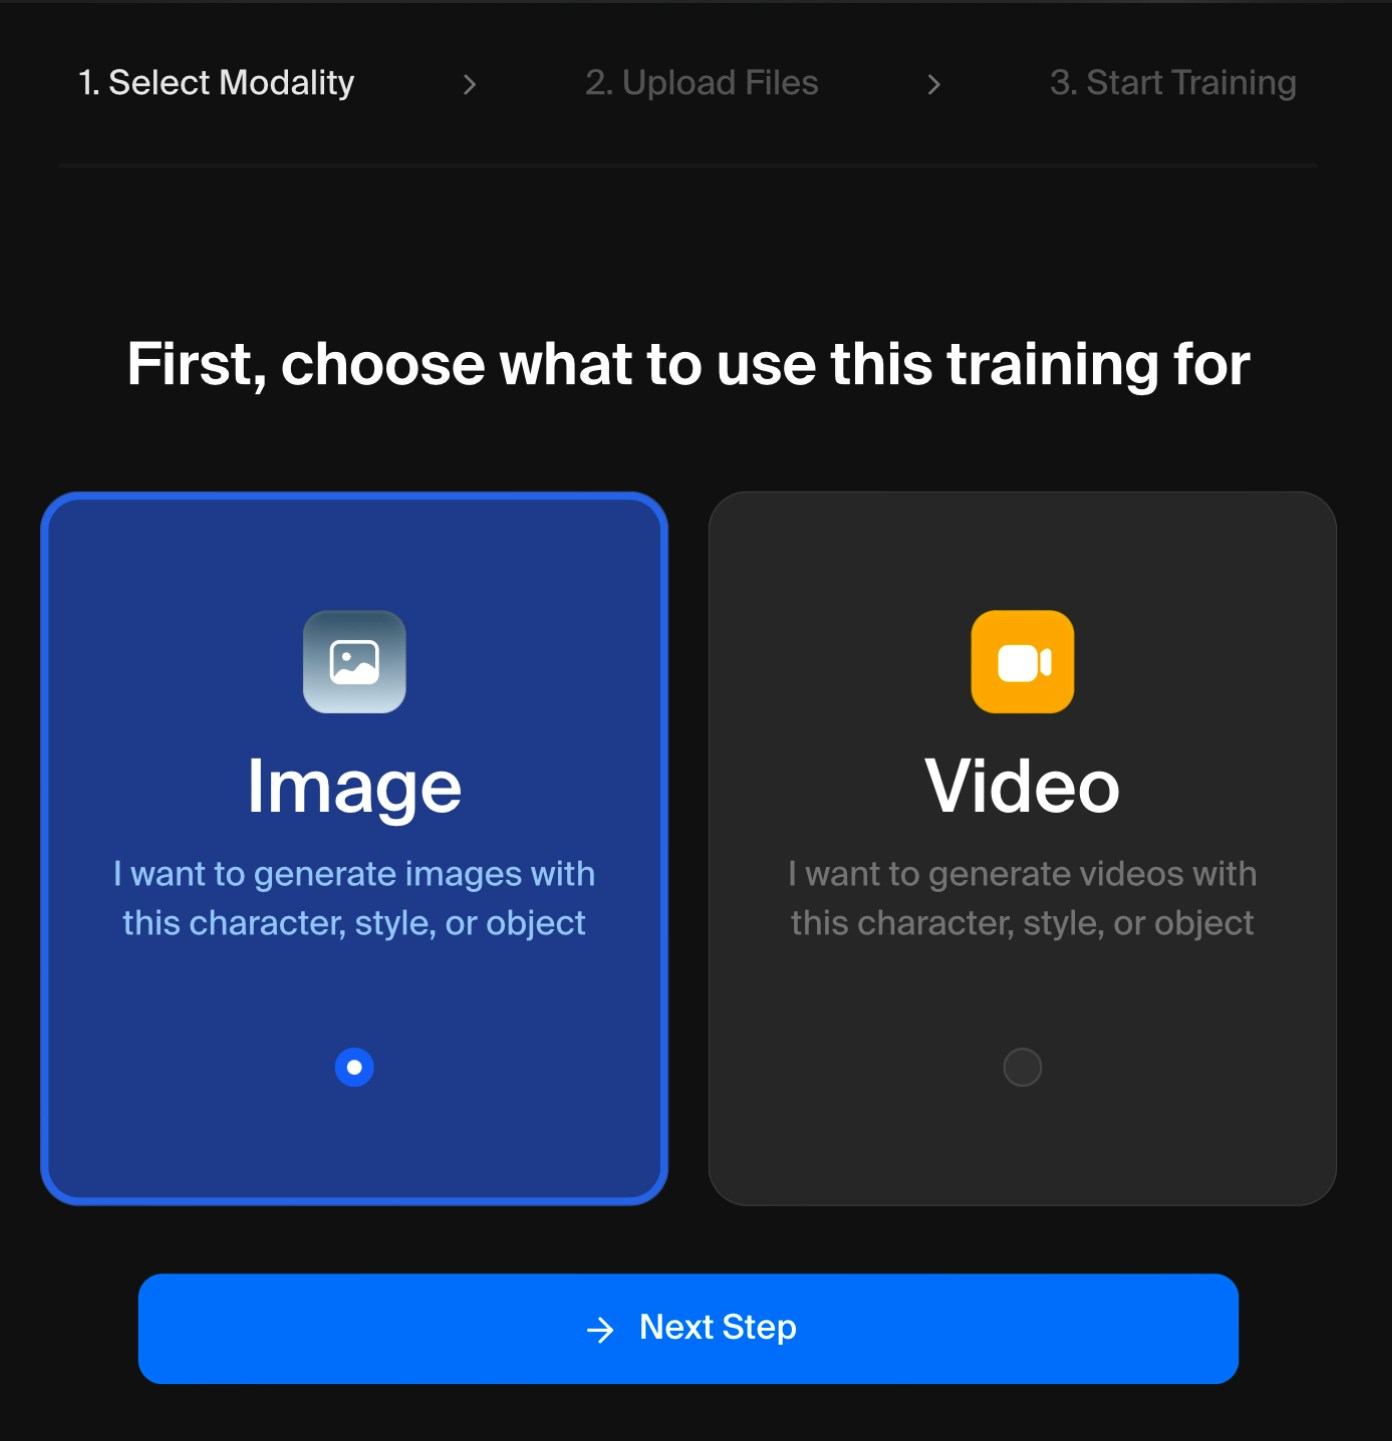
数据集类型
角色- 你可以训练模型来理解某个特定的手绘或渲染角色(插画、概念艺术、动画、电子游戏等)。也可以用真人的面部进行训练(当然,要经过本人同意)。
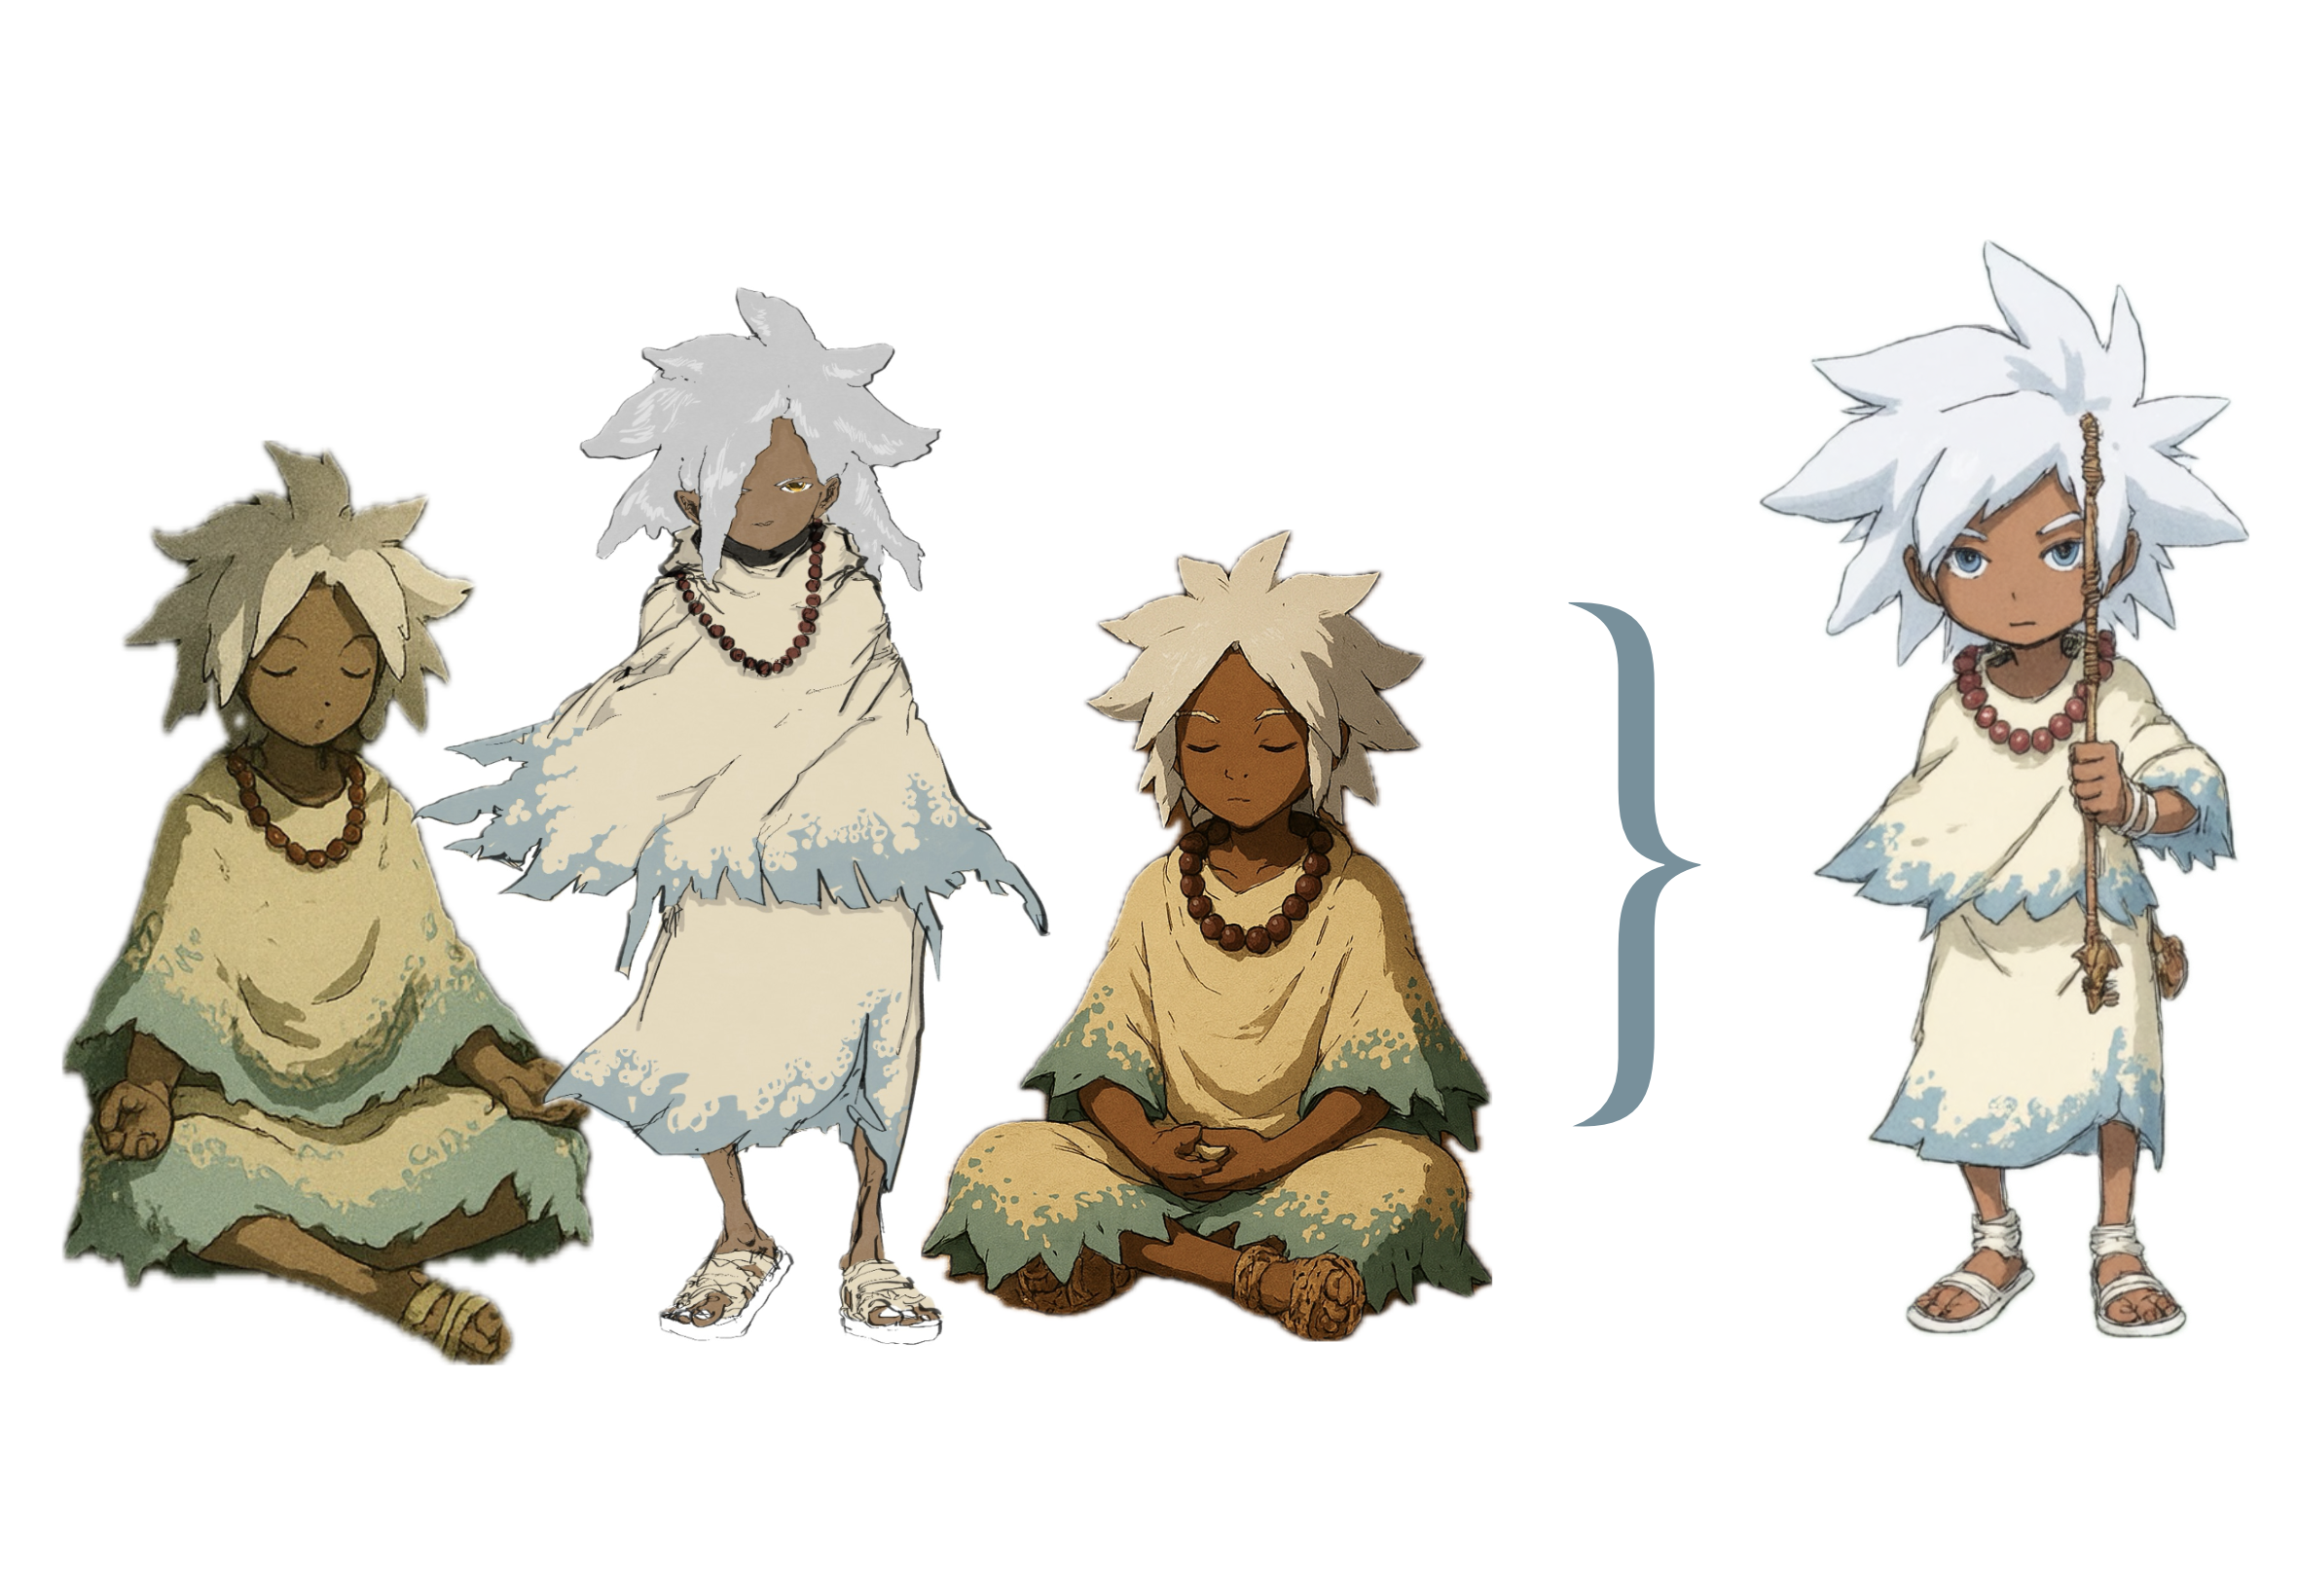
角色数据(右)与风格生成的角色(左)细节保持一致。
- 为保证一致性,尽量多用角色穿着完全相同服装的图像。最好包含各种姿势、角度和动作。
- 动画师和概念艺术家们——这和制作角色设定表的工作流程超级相似。
- 原则与角色训练相同——完全相同的物体、多个角度、用特写展现细节、用远景提供背景信息。
- 如果你是产品设计师或从事电商工作,就把你手上所有独特的产品图都上传吧。
- 空白或透明背景会有帮助,但并非必需,只要物体是图像的中心焦点即可。
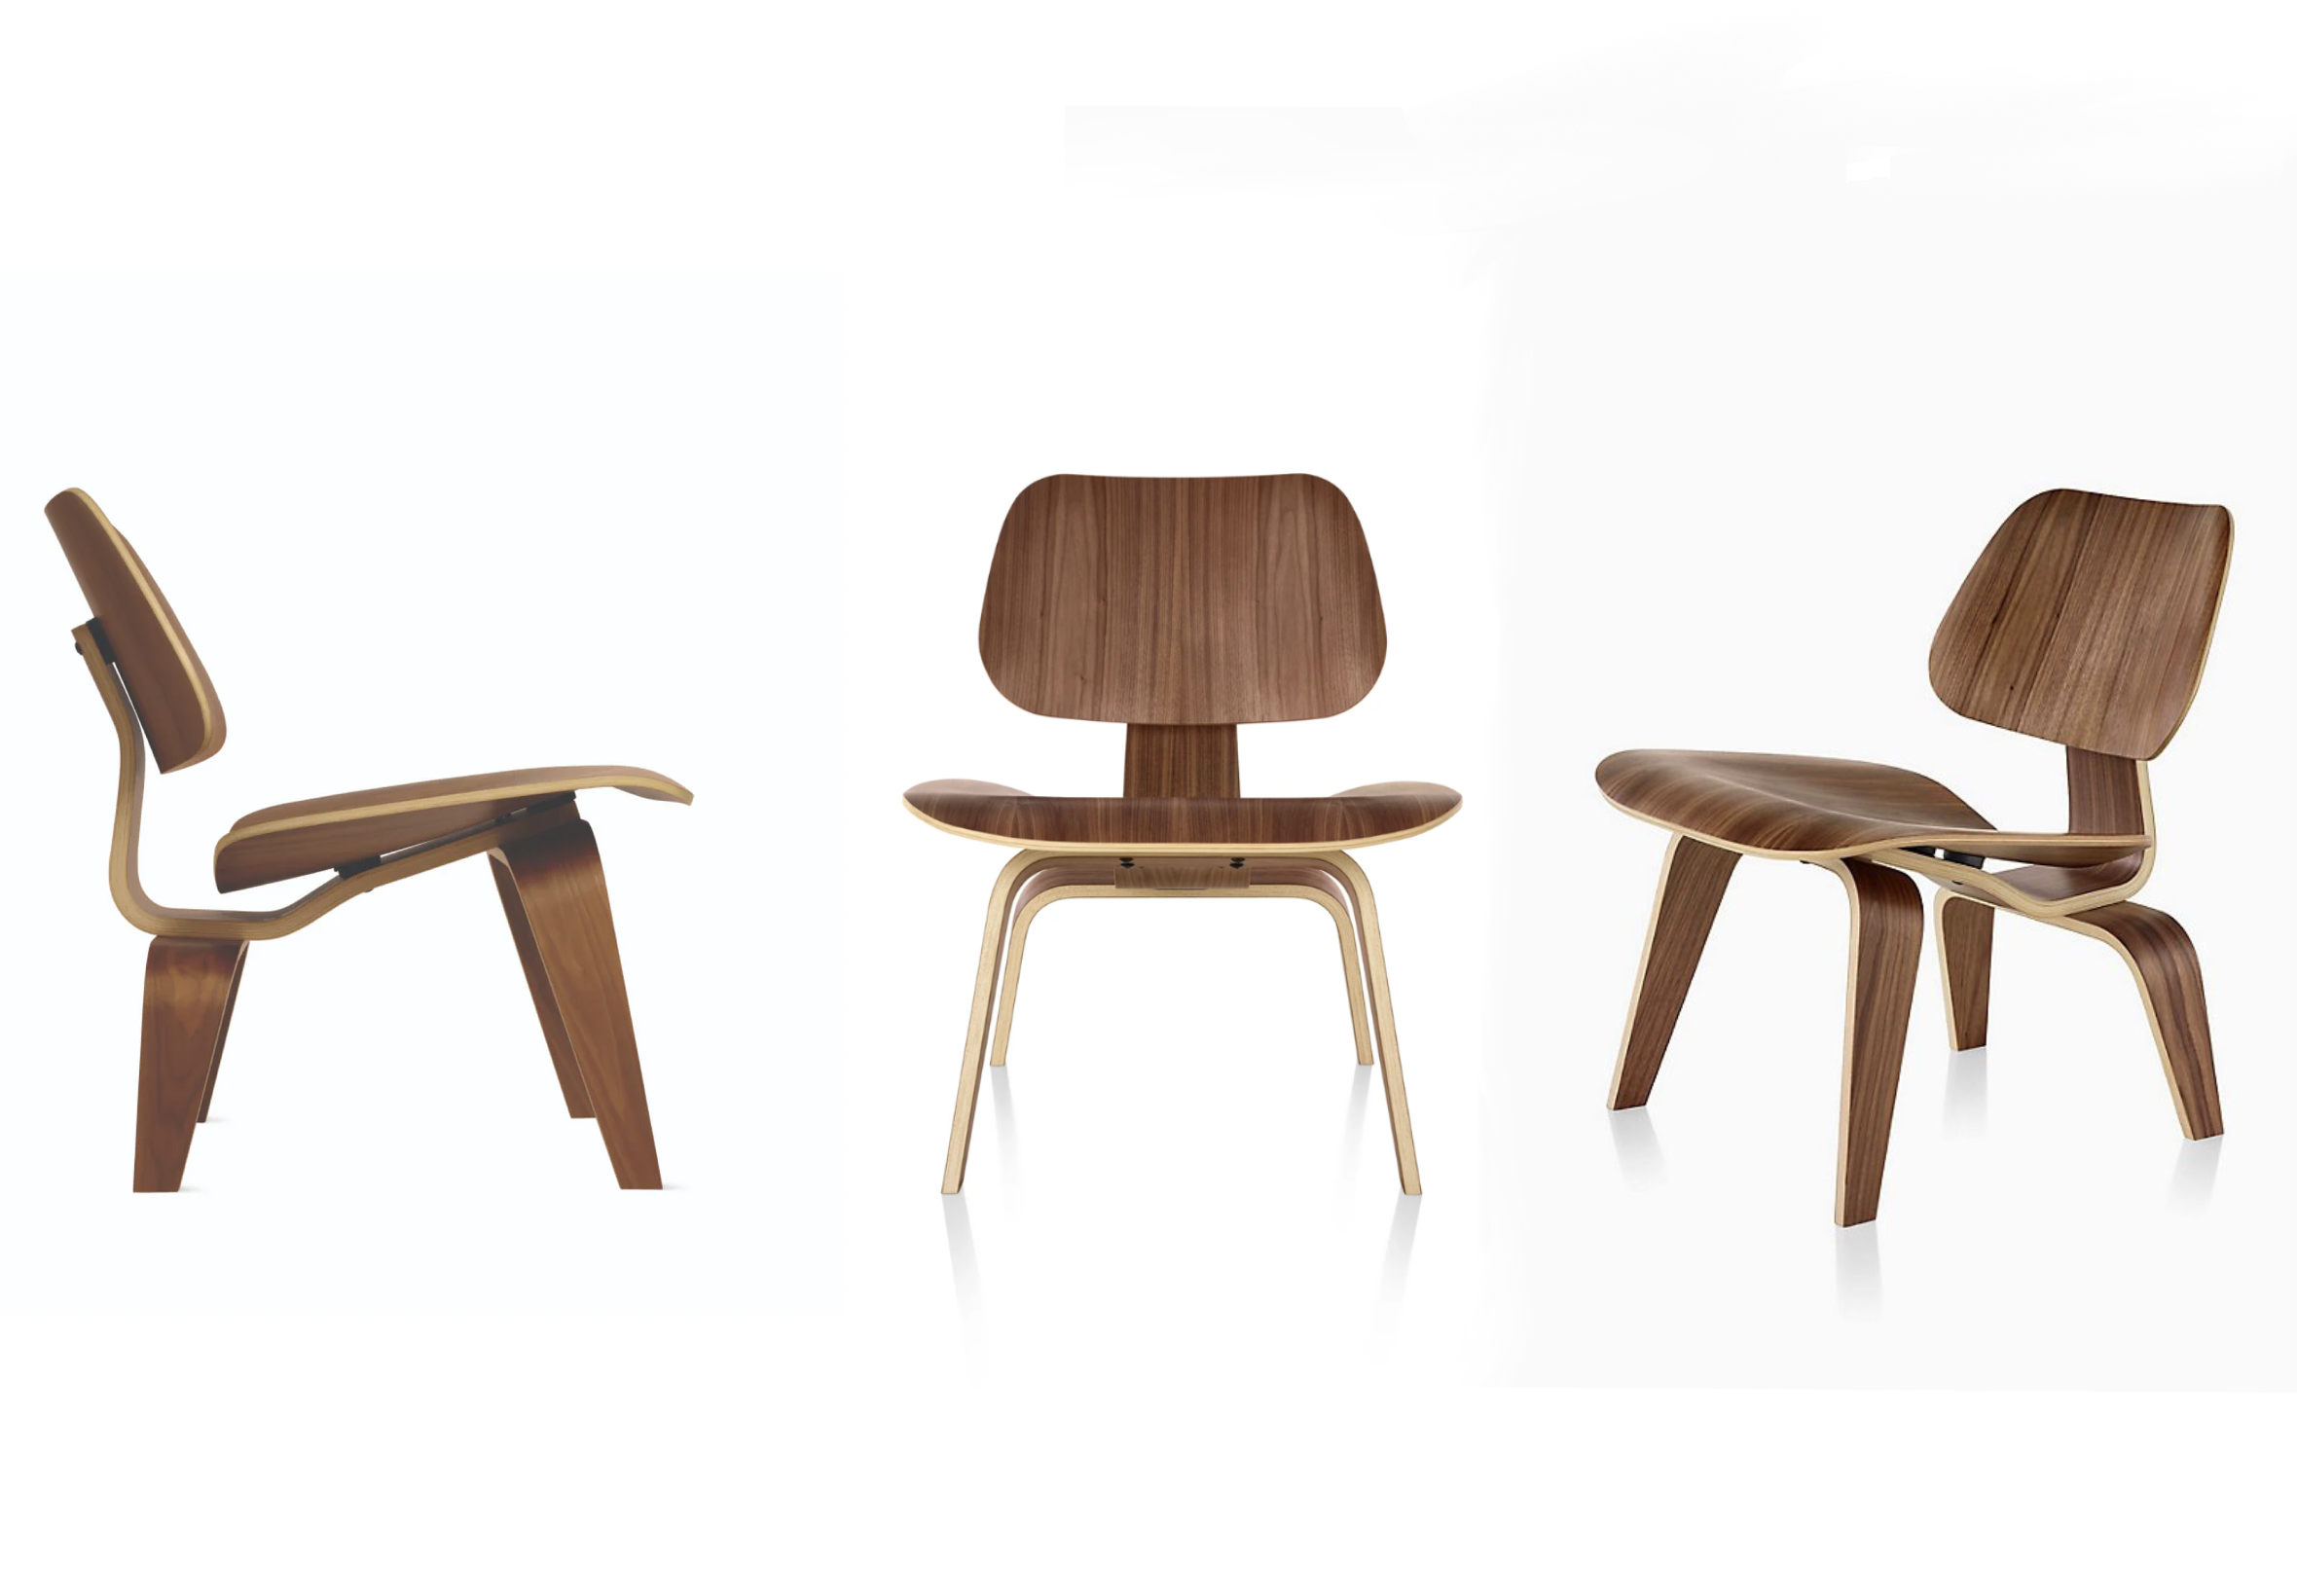
同一物体、不同角度、空白背景。这就是很棒的训练数据。
- 只要有任何一张图像里的物体或产品稍有不同,就会让模型困惑,导致结果浑浊。
如果产品上有文字,除非你有大量文字特写的训练图像,否则风格可能无法还原这些文字。不然就要做好出现伪影的准备。
- 这里的数据集可以更随性、更有创意。作品的美学或材质要完全一致,但主题可以而且应该非常多样。
- 油画、动漫、液态铬、大理石、低多边形——任何真正的视觉风格或媒介都行。
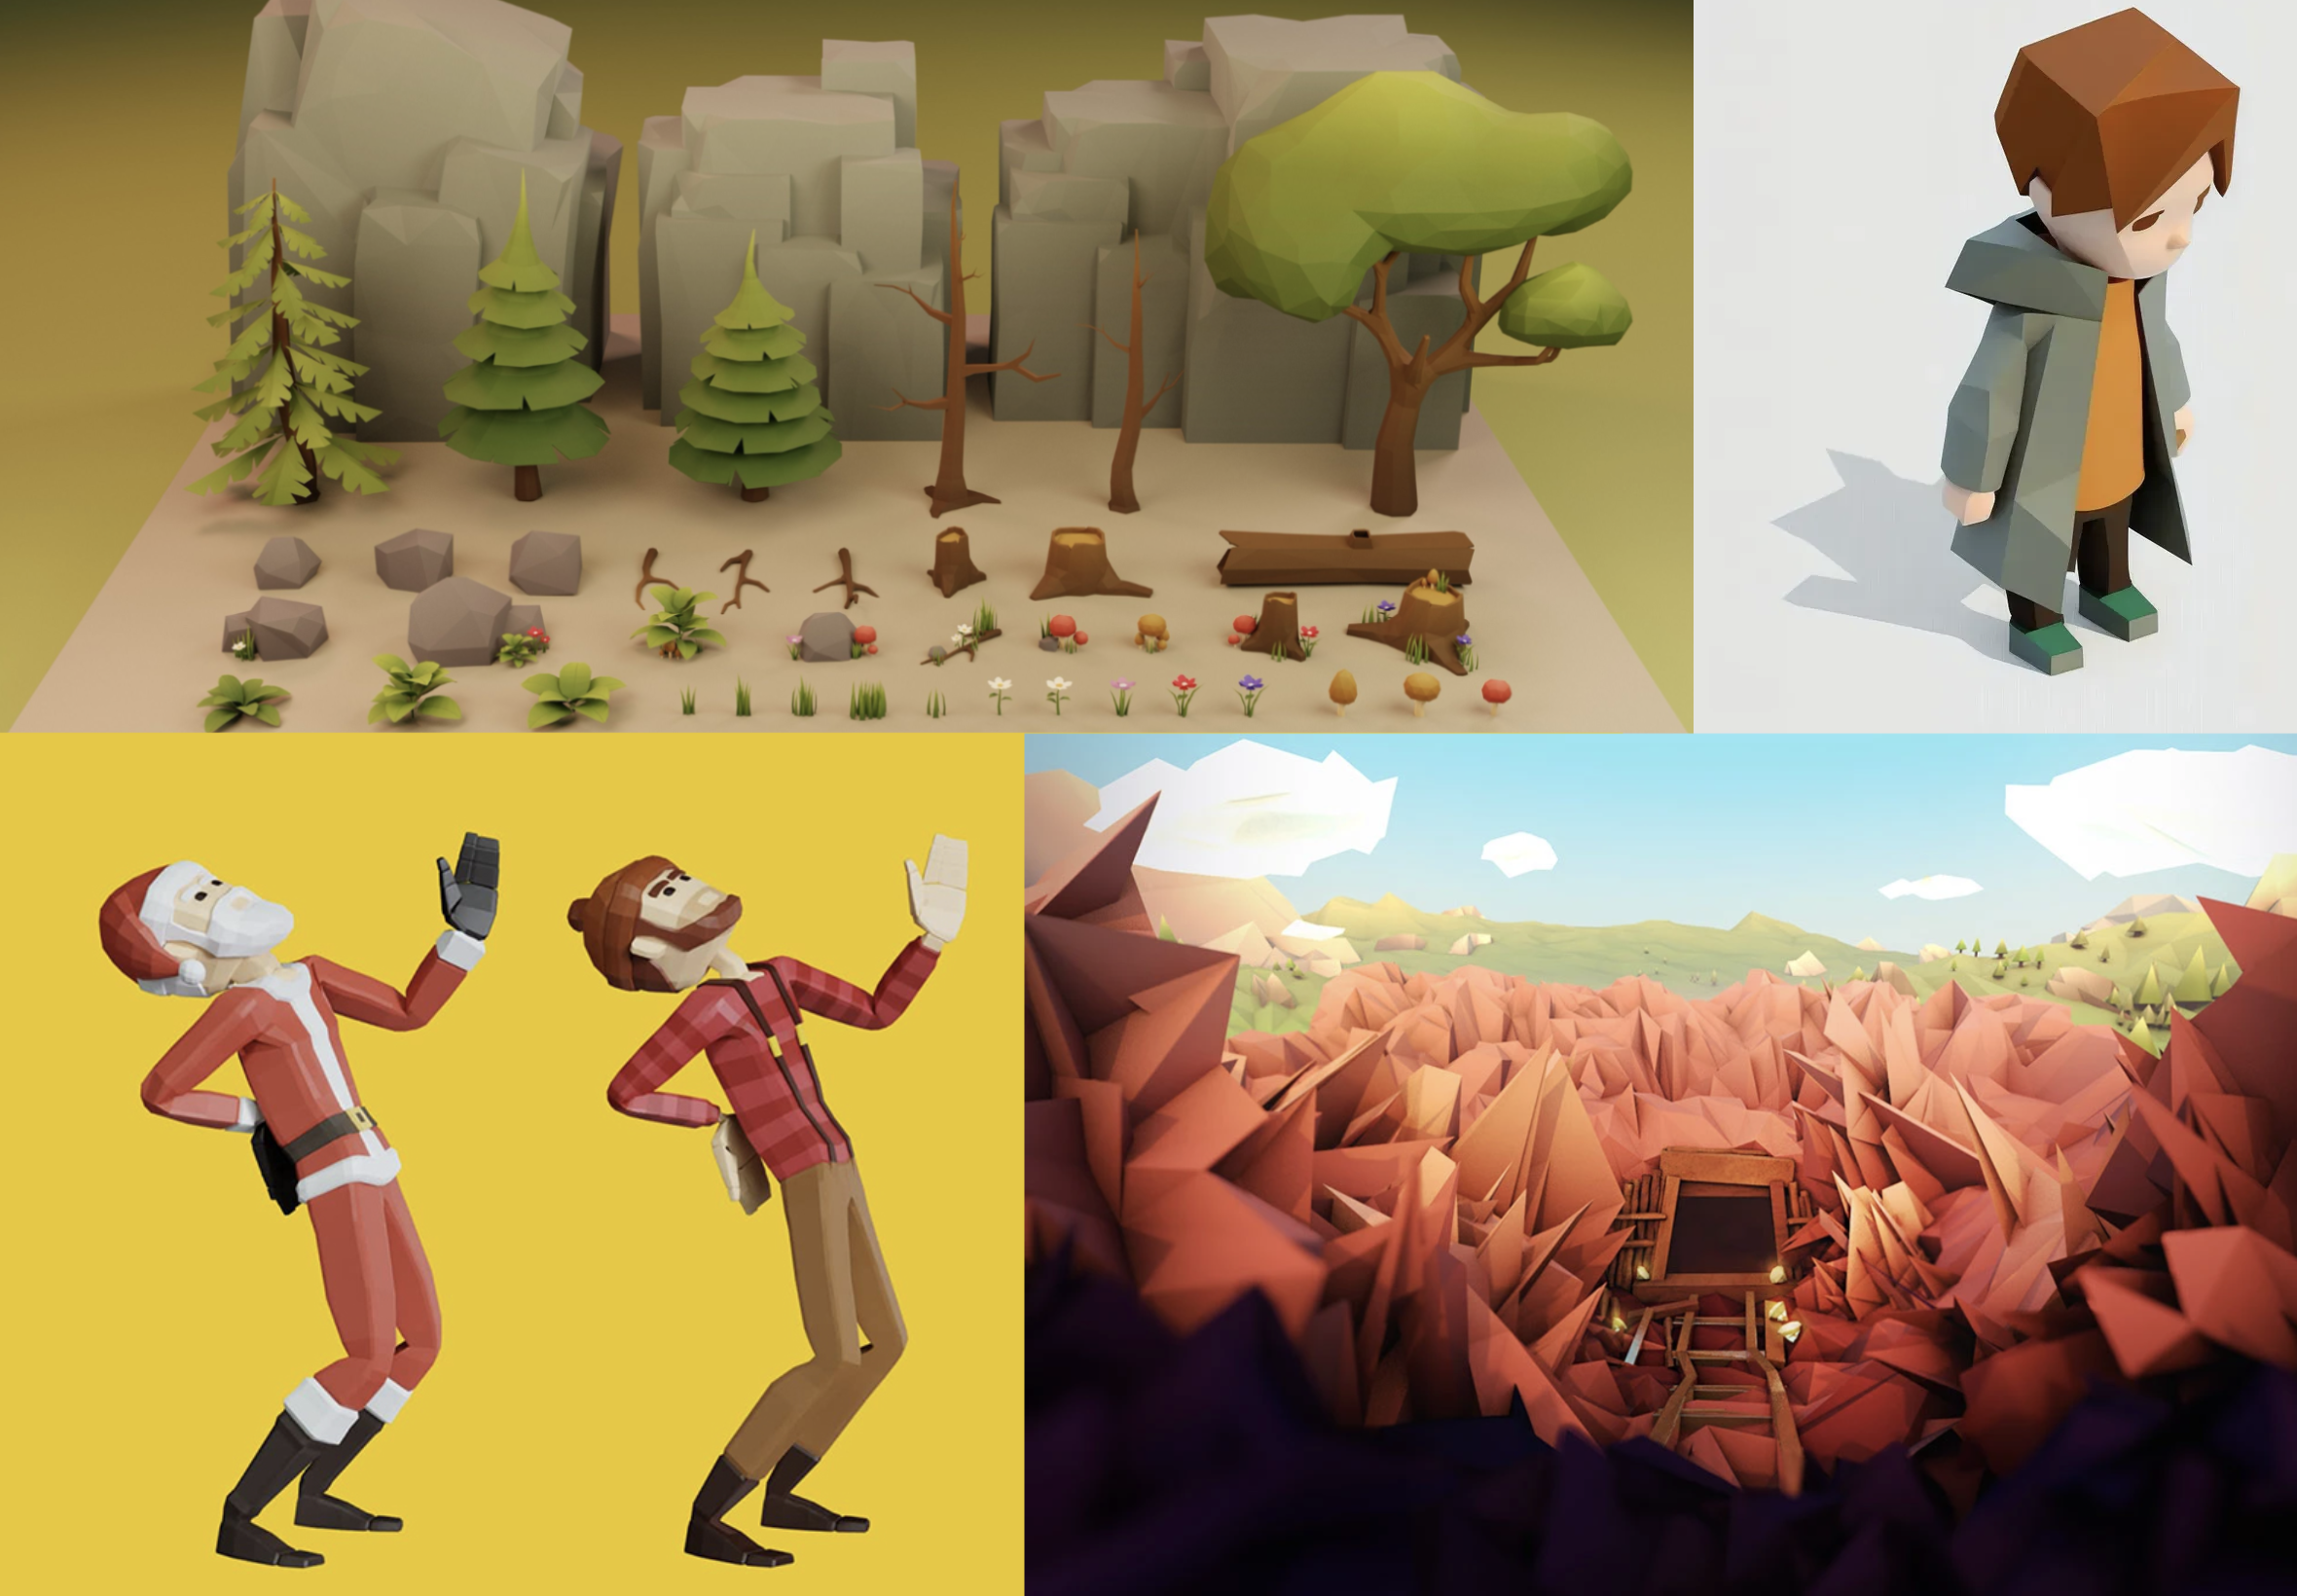
这份低多边形数据集的样本包含独特的角色和背景。
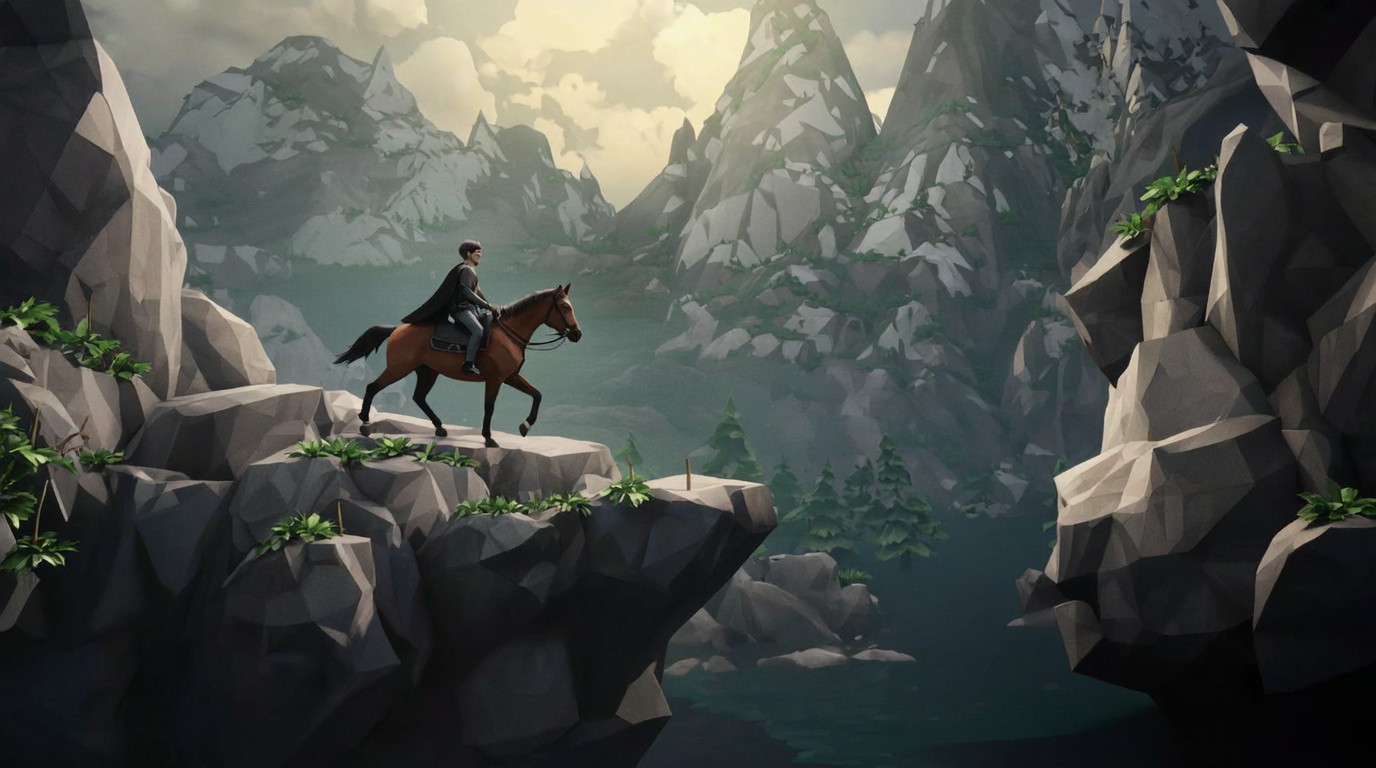
这张由低多边形风格生成的图像,创造了全新的主题和构图。
- 足够广泛的数据能防止风格对某个特定主题过拟合,让它真正具有创造力。
2. 精调
现在该调整技术参数了。Krea 会为你的 Custom Style 命名,并分配一个用于提示词的触发词(如有需要可以修改)。你还可以查看图像数量和平均分辨率的指示条。目前一切顺利。
模型
- Krea 的超能力在于它能运行多种顶级图像和视频生成模型。
- 每个模型都有各自的专长可供选择,但值得每个都试一试。快速概览:
步数
- 增加步数 = 花更多时间学习数据。但也可能消耗大量算力并导致过拟合,即风格只会照搬训练图像。一个不错的起始值是图像数量 x 20。
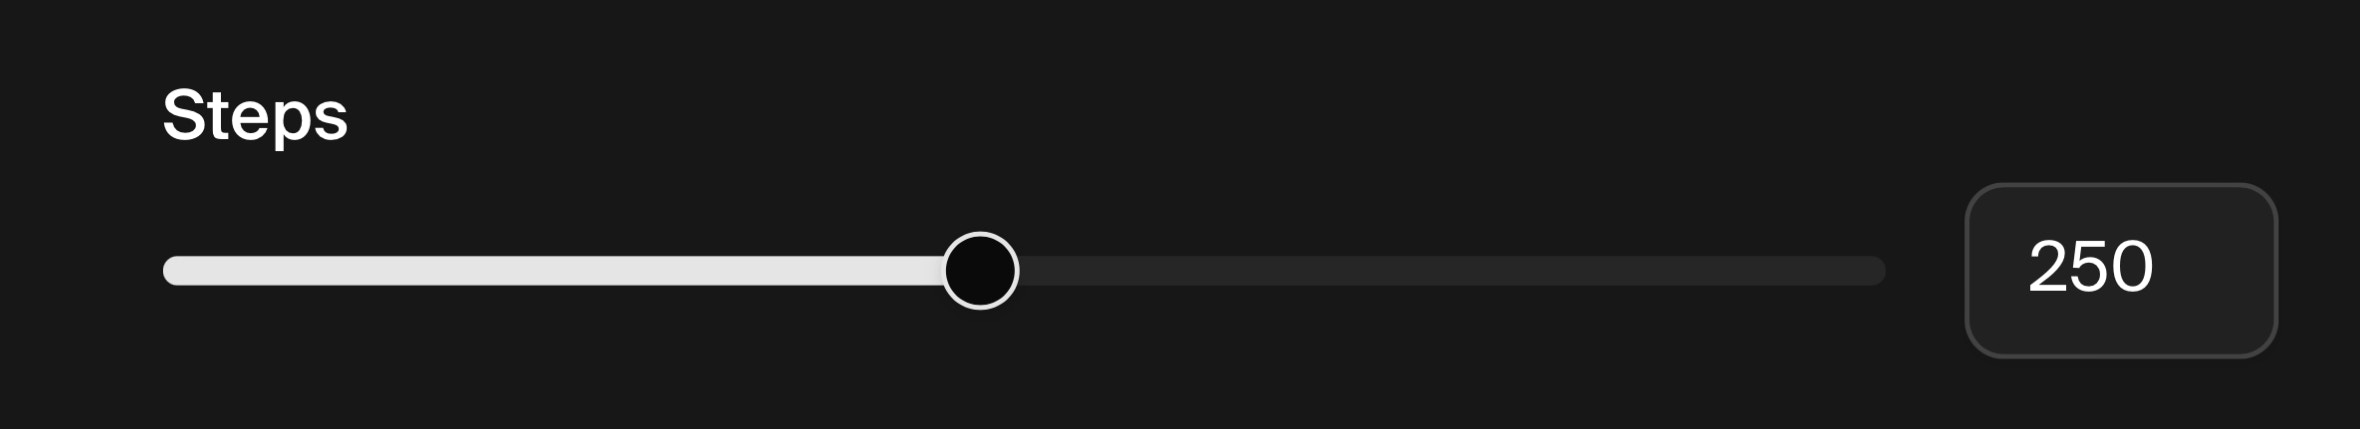
默认值:250。
学习率
- 较高的学习率可以加快训练,但也可能导致风格对数据过拟合。较低的学习率则需要更长的训练时间。
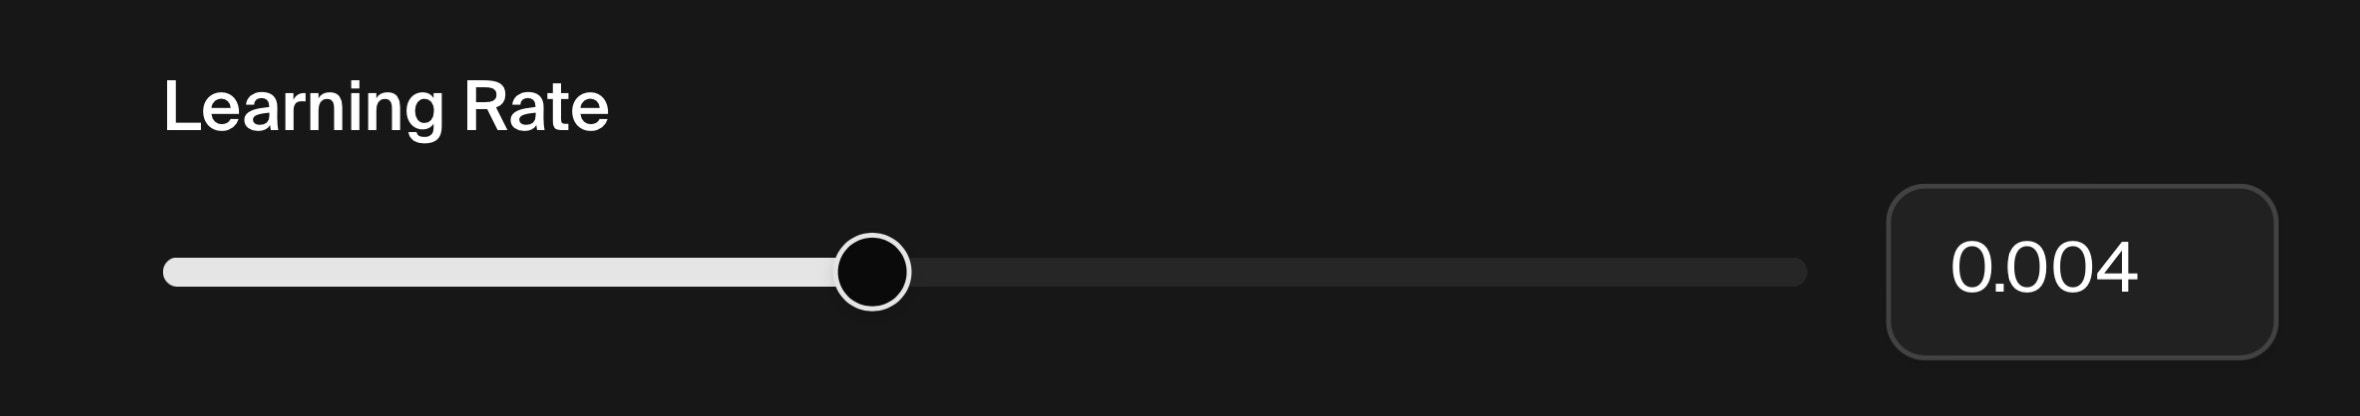
默认值:0.004 (4e-3)
批量大小
- 较大的批量大小可以加快训练,但也可能导致结果平庸。建议按比例调整 Batch Size 和 Learning Rate。对于小数据集,保持默认值即可。
默认值:1
3. 炼金
风格训练完成后,就该开始实验了。提示词大神们——这就是你们大显身手的时候。挑战风格的极限:
- 全力以赴,超越预期。找出优势和不足。发现并记录风格何时能生成出色的结果,何时不能。
- 如果输出对风格过拟合,可以考虑:
- 让训练数据更多样化
- 降低学习率
- 如果输出差异太大,可以考虑:
- 向数据集中添加更多图像
- 从数据集中移除较弱或差异过大的图像
- 提高学习率
- 如果输出对风格过拟合,可以考虑:
从这些非常相似的样本生成来看,这个风格可能过拟合了。再试一次。
重新训练
- 换一个模型试试
- 某个模型可能比另一个更能捕捉你的风格。多比较比较,Krea 就是为此而生的。如果不确定,请参考上面的模型对照表。
- 合并数据集
- 将两个或更多数据集组合起来,能创造出真正独特的美学。当你被某个风格的局限卡住或感到沮丧时,为它注入新的生命力。
- 持续实验
- 增加或减少图像数量。
- 确保所有图像都是高分辨率。
- 摆弄一下 Krea 的微调设置。